量化分析告訴我底妝的模型負面比例最高(26.2%),但沒說為什麼;後來的 LLM 盲標檢查也顯示,模型的負面標籤多半不是負面(見第 3 篇),所以這個數字只當「先讀哪裡」的線索。我把保養 864 篇、底妝 926 篇候選各縮到 24 篇完整閱讀並分流,得到的是「值得驗證的假設」,不是市場比例;而且這兩輪讀文都是 AI 輔助、尚未經人工覆核。
商業問題
前幾篇的數字能指出「先看哪裡」:底妝主題的模型負面比例明顯高於其他主題(見第 3 篇),雖然模型驗證後這個差異站不住,仍足以決定先讀底妝。而且即使負面比例可信,它也回答不了產品團隊與客服團隊真正要問的事:顧客到底卡在哪一步?是資訊不夠、試用不夠,還是買完之後沒人接?
這個答案會決定資源放在哪裡:內容團隊要補產品說明,服務團隊要設計購後入口,還是根本不該再加促購文案。所以我的主軸是:量化指出哪裡痛,質性閱讀說明為什麼痛。
資料與方法
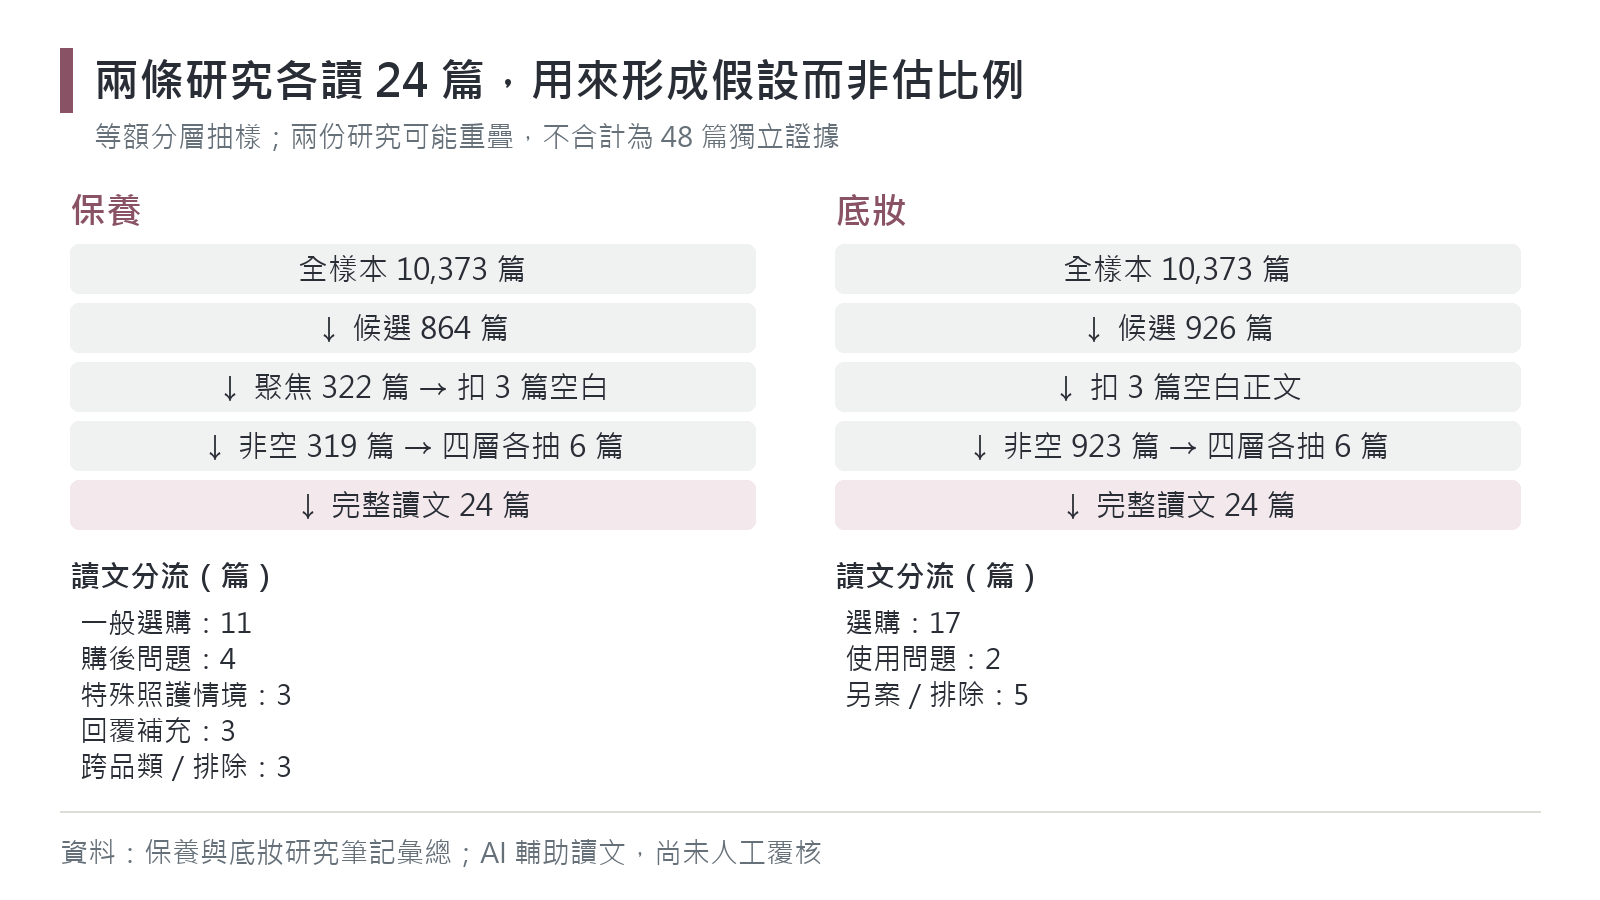
資料來自既有的 10,373 篇社群樣本(Dcard 4,683、PTT 5,690)。我用同一套漏斗各做保養與底妝兩輪:
- 關鍵詞篩選:標題與正文含品類詞,且標題含「請益、求推薦、請問、選擇、怎麼選、二選一」這類提問詞。
- 收斂:保養再要求標題本身含保養詞,並排除底妝、唇、眉、睫毛等跨品類詞。
- 去空白:正文空白的篇數另列未讀。
- 分層抽樣:依「平台 × 正文長度(600 字以下/以上)」分四層,每層用固定亂數種子各抽 6 篇,共 24 篇。
- 完整閱讀並分流:每篇只歸一個主要類別,混合內容另註記。
| 步驟 | 保養 | 底妝 |
|---|---|---|
| 樣本 | 10,373 | 10,373 |
| 候選 | 864 | 926 |
| 進一步收斂 | 322 | 不適用 |
| 正文非空 | 319(空白 3) | 923(空白 3) |
| 讀文 | 24(13,074 字元) | 24 |
為什麼要分層?候選裡長文很少:保養的 PTT 長文只有 7 篇,Dcard 長文 24 篇。如果純隨機抽 24 篇,幾乎只會讀到短文。分層等額抽樣能讓長文也被讀到,代價是長文比重被放大。因此這 24 篇不能換算成母體比例,也不能比較平台。
分流的目的是不把不同性質的問題混在一起:
| 分流 | 保養(24 篇) | 底妝(24 篇) |
|---|---|---|
| 一般選購 | 11 | 17 |
| 購後問題/使用問題 | 4 | 2 |
| 特殊照護情境 | 3 | 不適用 |
| 回覆補充 | 3 | 併入另案 |
| 跨品類/排除 | 3 | 5(另案/排除) |
兩份筆記的分流類別略有不同,這是各輪依內容調整的結果。
發現
保養的三個發現:
- 產品角色不清楚,會延伸到買完之後。 有多篇是品類或版本難以辨認(乳霜、精華、同系列版本差異);另有已購買的人仍不知道多項產品的先後與角色。這提示的方向是先測試產品角色說明與資訊一致性,而不是增加促購文案。
- 能不能持續做、負擔多少,會影響取捨。 多步驟難以維持、不想再加買、預算有限、在意價格容量,都出現過。「尋求建議」不等於「加購機會」。
- 購後資訊問題與品質、不適回報要走不同入口。 前者是內容與資訊一致性,後者需要客服受理與適當升級;涉及診療的情境更不該由促購內容承接。這是服務設計假設,不是產品缺陷統計。
底妝的三個發現:
- 試用後仍可能缺情境證據:試用時間太短、櫃上與日光下顏色不同,或需要整天觀察。反例是有人已試妝,仍在比較通路與價格,所以不能把猶豫都歸為試用不足。
- 選色常需要「現用產品」與「希望妝感」的背景,但不能承諾跨品牌色號一對一等同。
- 生活情境與購買階段會改變回應方式:妝效與持妝取捨、通勤便利,與已上妝後的使用問題,要的是不同回應。
商業建議
- 產品與內容團隊:先做產品角色比較與版本差異說明,再談促購。 觀察指標是顧客能否正確辨識品類(驗證設計見第 8 篇)。
- 客服團隊:把「資訊不清楚」「不適或品質回報」「需專業判斷」分成三個入口。 看轉接是否正確、需人工協助的比例,而不是看購買。
- 會員與櫃位團隊:對已領試用品但未購買的顧客,試做情境觀察加後續諮詢,而不是只發折扣提醒。 先小規模確認流程可用,再看有效諮詢完成率。
限制與下一步
- 兩輪讀文都是 AI 輔助探索,沒有人工獨立覆核,也沒有計算標註準確率。 分流結果只是 AI 的判讀,不是已確認的標註。
- 24 篇等額抽樣提高了長文比重,不能算痛點普及率、平台差異或品牌勝負;文章數也不等於顧客人數。
- 保養與底妝兩份筆記,加上先前的主題探索,可能重疊,我不合計成 48 篇或其他獨立證據數。
- 日期尚待核實(見第 1 篇),不能說這些是近期趨勢;品牌篩選也只涵蓋既有 12 個品牌,不代表全市場。
- 關鍵詞仍會誤收,例如名稱含保養詞但實際在談妝前品,必須讀文後排除。
- 下一步:由人工覆核一部分分流,再把假設寫成可驗證的實驗。
這篇展現的能力
- 分層抽樣設計:知道純隨機會漏掉稀少但重要的長文,並明確承認這種抽法的代價。
- 質性資料的分流與去識別:把雜訊(跨品類、回覆他人)與核心證據分開,並只用改寫摘要,不保留原文。
- 把量化與質性接起來:用量化縮小範圍、用質性解釋原因,最後輸出可驗證的假設。
- 研究誠實度:清楚標示 AI 判讀、未覆核、不可外推,避免把探索包裝成結論。