在 10,373 篇社群樣本中,已分配到底妝且語氣判讀成功的 2,382 篇裡,模型判為負面的比例是 26.2%(分母不是 10,373 篇),95% Wilson 區間為 24.4%~28.0%,下界高於次高主題的上界 19.0%。但我用 120 筆分層樣本做 LLM 盲標一致性檢查,模型與 LLM 判讀依母體比例加權的一致率只有 36.9%,kappa 約 −0.06,和隨機差不多;模型判為負面的 40 篇只有 3 篇被判為負面。所以區間雖然不重疊,仍不能當成「底妝負面討論最多」的證據;在模型改善並完成人工驗證前,五個主題都不排名。
商業問題
品牌與零售團隊的資源有限,每一季只能挑一兩個議題深入處理:改善商品說明、調整櫃位話術,或安排顧客訪談。如果只看各主題的負面比例點估計,排出第一名到第五名很容易,但差 1 到 2 個百分點是真實差異,還是抽樣的隨機波動?更根本的是:模型說的「負面」,真的是負面嗎?
這篇文章要回答的是:哪個主題的負面討論明顯偏多,值得先投入?這個判斷能不能相信?這裡的「負面」指討論中的負面語氣,不是對任何品牌或商品的指控。
資料與方法
資料是儀表板快照中的 10,373 篇(Dcard 4,683、PTT 5,690)。每篇由模型判讀語氣(正面、中性、負面)並分配到五個暫定主題。主題名稱尚未經人工確認。語氣判讀另以 120 筆分層樣本做 LLM 盲標一致性檢查(見下文「模型驗證」);人工標註尚未完成,所以沒有人工準確率。
- 分母:已分配主題且成功判讀語氣的篇數;判讀失敗的 94 篇不入分母。
- 負面比例 = 負面篇數 ÷ 成功判讀篇數。
- 信賴區間用 Wilson 法(z = 1.96,95%)。比起傳統的「比例 ± 誤差」,Wilson 在樣本較小或比例偏低時更穩定,不會出現低於 0 的下界。
白話:區間是在說「如果用同樣方式再抽一批類似的樣本,真實比例大約會落在這個範圍」。區間愈寬,代表篇數愈少、愈不確定。但區間只處理抽樣誤差;模型把語氣判錯,是另一種誤差,區間完全不會反映。
發現
| 主題(暫定) | 成功判讀篇數 | 模型負面篇數 | 模型負面比例 | 95% 區間 |
|---|---|---|---|---|
| 底妝 | 2,382 | 623 | 26.2% | 24.4%~28.0% |
| 專櫃試用與贈品 | 2,338 | 407 | 17.4% | 15.9%~19.0% |
| 唇彩 | 1,825 | 291 | 15.9% | 14.3%~17.7% |
| 保養保濕 | 2,877 | 422 | 14.7% | 13.4%~16.0% |
| 眼妝 | 856 | 91 | 10.6% | 8.7%~12.9% |
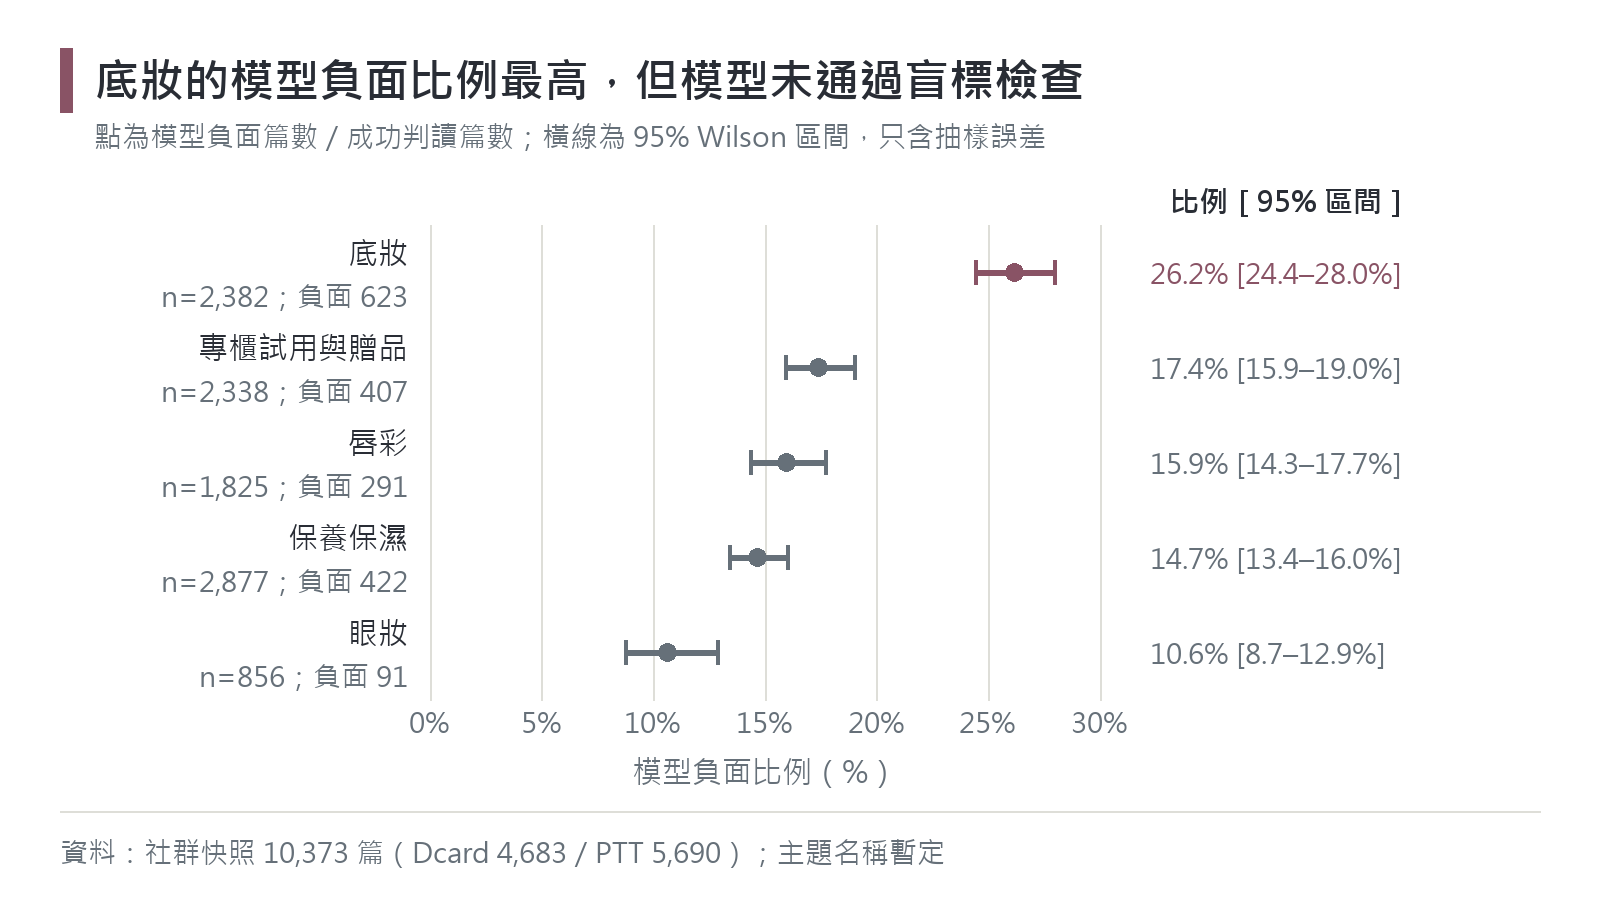
只看模型輸出,有三個觀察:
- 底妝的模型負面比例明確領先。 它的區間下界 24.4% 比第二名專櫃試用與贈品的上界 19.0% 還高 5.4 個百分點,兩者不重疊。這時說「模型判讀的底妝負面比例較高」,有統計上的依據;但下一節的驗證顯示,這不等於底妝的負面討論較多。
- 中間三個主題分不出順序。 專櫃試用與贈品、唇彩、保養保濕的區間(15.9%~19.0%、14.3%~17.7%、13.4%~16.0%)互相重疊。點估計排了第 2、3、4 名,但差距不夠大,我不會把它寫成排名。
- 眼妝最低,但也最不確定。 10.6% 看似負面語氣最少,不過只有 856 篇,區間寬約 4.2 個百分點,是五個主題中最寬的。
全樣本的語氣分布也提供背景:成功判讀 10,279 篇中,中性占 68.0%,負面 1,835 篇(17.9%),正面 1,459 篇。
模型驗證:負面標籤站得住嗎
為了知道模型的「負面」能不能信,我做了一次盲標一致性檢查:
- 抽樣框: 原始處理流程沒有保留逐篇標籤,我重建貼文母體後,只採用「原模型標籤能從公開彙總確定」的 4,426 篇(中性 3,583、負面 468、正面 375)。
- 分層抽樣: 每個模型標籤各抽 40 篇,共 120 篇;各層的 PTT/Dcard 篇數依母體比例分配,固定亂數種子。
- 盲標: 打亂順序、隱藏模型標籤後,由 Claude(Sonnet)依同一份標註指南逐篇判讀整體評價。指南的關鍵規則是「描述膚況並發問算中性,抱怨自己的不好經驗才算負面」。這是 LLM 標註,不是人工驗證。
| 模型標籤 \ LLM 判讀 | 正面 | 中性 | 負面 |
|---|---|---|---|
| 正面(40 篇) | 14 | 23 | 3 |
| 中性(40 篇) | 21 | 18 | 1 |
| 負面(40 篇) | 15 | 22 | 3 |
| 指標 | 樣本原始值 | 依母體比例加權 |
|---|---|---|
| 一致率 | 29.2%(Wilson 21.8%~37.8%) | 36.9%(26.3%~47.8%) |
| Cohen's kappa | −0.06(−0.18~0.05) | −0.06(−0.15~0.05) |
| 負面精確率(模型判負面中,LLM 也判負面) | 7.5%(Wilson 2.6%~19.9%) | 同左 |
樣本是每類 40 篇,但母體有 68% 是中性,所以整體一致率以加權值為準(每層按母體篇數 ÷ 樣本篇數加權);精確率在兩種算法下相同。加權值與 kappa 的區間用分層 bootstrap(10,000 次)估計。
結果很清楚:kappa 接近 0,代表模型與 LLM 判讀的一致程度跟隨機差不多。模型判為負面的 40 篇裡,22 篇被判為中性(多半是描述膚況後發問、活動或兌換規則詢問、促銷資訊),15 篇被判為正面(例如心得裡用到「暗沉」這類負面詞,但結論是滿意)。依 LLM 判讀加權估計,負面貼文約占 4.1%(95% 區間 1.2%~8.6%),遠低於模型的 17.9%。
這次檢查本身也有限制:LLM 可能有自己的判讀偏誤;抽樣框不是完全隨機,偏向 Dcard 與某些主題(平台已在抽樣時按母體比例修正);每類 40 篇也不夠按主題拆解。所以 7.5% 不是精準數字,但即使區間取上界 19.9%,模型的負面標籤仍有八成以上站不住。
底妝高負面背後可能是什麼
點估計只告訴我「哪裡」,不告訴我「為什麼」。我另外對底妝做了一輪質性閱讀:從 926 篇候選中,扣掉 3 篇正文為空,分層抽出 24 篇讀完(流程見第 7 篇)。這 24 篇多半是選購提問,發現的重點是:消費者即使試用過,仍可能缺少自己情境下的證據,例如試用時間不足、光源改變,或需要持續觀察;選色則需要既有產品的背景。
這些是樣本中的問題類型,不是市場痛點排名,也不能解釋 26.2% 的來源。讀文時我就懷疑出油、脫妝這類使用描述會被模型判成負面,上一節的驗證支持這個疑慮:底妝的高「負面」比例,很可能主要反映提問與描述,而不是對品牌不滿。把讀文發現轉成可驗證的實驗設計,見第 8 篇。
商業建議
- 先校正情感模型,再談底妝是否優先。 驗證顯示模型的負面標籤多半不是負面,現在依 26.2% 投入資源缺乏依據。負責資料的人下一步是完成人工標註,改用能分辨「描述問題」與「抱怨」的判讀方式,再重算各主題比例與區間。底妝的質性讀文結果(試用情境、選色背景)不依賴情感模型,仍可交給內容與顧客經營團隊使用。
- 模型通過驗證前,五個主題都只監測、不排名。 現在連第一名都站不住,中間三個主題的區間又互相重疊,任何排名都缺乏依據。
- 眼妝先補樣本再下結論。 即使模型改善,眼妝篇數仍少,需要累積更多篇數,否則「眼妝很好」可能只是樣本小。
- 報表一律附區間、篇數與模型驗證結果。 在給主管的簡報中,每個比例旁邊標上分母;用模型產生的比例,還要附上模型的一致率或準確率,避免把模型誤判當成市場差異。
限制與下一步
- 區間只反映抽樣誤差,不包含模型誤判。LLM 盲標檢查顯示誤判很大(加權一致率 36.9%),這是最大的限制;人工標註尚未完成。
- 一致性檢查用的是 LLM 標註,抽樣框也不是完全隨機(見上文),只能說明模型不可靠,不能精準估計真實負面比例。
- 主題名稱是暫定的,尚未人工確認,「底妝」的邊界可能與真實內容有落差。
- 負面比例是討論中的語氣,不代表商品品質、銷量或品牌好感。
- 底妝質性閱讀只有 24 篇,無人工覆核,不能算母體比例。
- 樣本含 PTT,其日期尚待核實(見第 1 篇),所以我只做主題比較,不做時間趨勢。
- 下一步:用同一份 120 筆樣本完成人工盲標,比對人工、LLM 與模型三方;改善情感判讀後重算本篇的比例與區間;並確認主題名稱。
這篇展現的能力
- 不確定性的量化:用 Wilson 區間而非單看點估計,並說明區間只涵蓋抽樣誤差。
- 模型驗證:設計分層盲標樣本,用混淆矩陣、kappa 與加權估計檢查模型,並分開報原始值與加權值。
- 修正自己的結論:驗證結果推翻了「底妝負面最高」的初步判斷後,改寫建議,而不是只在角落加註。
- 量化與質性結合:用數字找出先讀哪裡,再用小樣本閱讀補上可能的原因,並清楚標示各自的限制。